 abstrx.ai
押注AI后训练数据的下半场
AI后训练(post-training)数据市场,正在经历一场不动声色的爆发。
在美国,Surge AI和Mercor的估值双双攀上200亿美元;Mechanize从创立到被谷歌DeepMind砸下15亿美元收入麾下,只花了不到一年半的时间。而作为YC史上收入增速最快的公司之一,AfterQuery的爆红传递了一个明确的信号:硅谷头部的VC们,已经彻底推翻了对数据市场的旧有认知,一个具备万亿美元潜力的市场正在崛起。
而正如历史上每一个高速膨胀的市场一样,数据行业并不缺乏鱼目混珠的玩家。
26年八月底,匿名“吹哨人”Utah teapot在X上爆料:行业内大量提供商缺乏合格的质检机制,数据生产者被鼓励使用AI草率赶工,在未经严格验证的情况下批量交付训练数据。如果把AI比作学生,那么漏洞百出的训练环境,就像是一间只鼓励应试技巧和走捷径,却忽视了“真正理解”的教室。
随着顶尖AI实验室愈发关注模型的安全与对齐,数据验收的机制正日益成熟。我们判断:数据市场的竞争,已经开始告别单纯的“堆数量”,转向依靠高效的生产流程与严格的质检,来持续交付高质量的数据。
这也是筹象科技成立的初衷:我们希望为AI提供一个更扎实的学习环境,让它在解决真实世界问题的过程中成长。
为什么是AI后训练数据市场?
如果把AI比作学生,阅读资料、学习示范能够帮它完成早期的知识积累,这正是预训练与监督微调所做的事情。但在真实的工作场景中,它还需要处理不完整的信息、调用外部工具、在试错中发现问题,并在多重约束下达成目标。
正如学生需要走出课堂、通过实习来积累经验一样,模型也需要一个能够反复演练、并获得可靠反馈的场地。我们在做的,就是为AI搭建一个与业界日常工作流无缝接轨的实战环境。当我们希望模型突破现有互联网语料的限制,去掌握其中没有充分包含的能力时,这样一个高质量的训练环境就显得尤为关键。
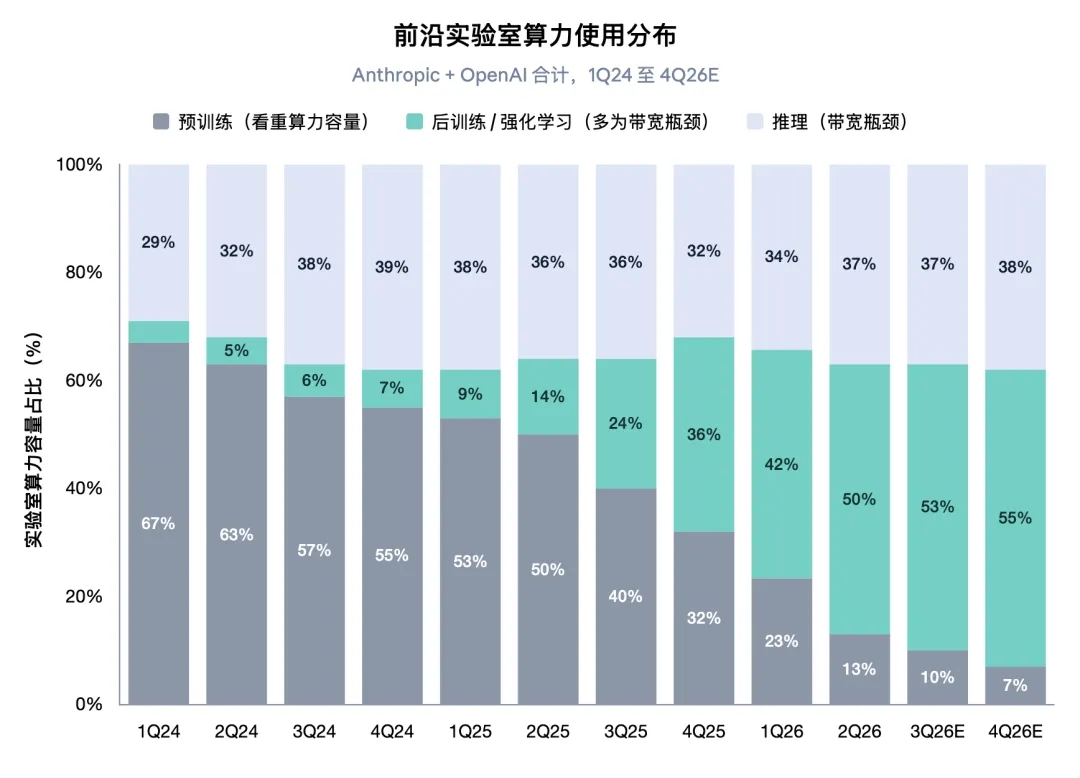
2026年9月,DeepSeek发布V4.1-Flash。模型报告中的一句话反映了当下大模型训练的重中之重:
“在当前阶段,改进数据与环境的生产流程,其边际收益显著高于后训练算法创新。”
训练数据需要更严格的质量把控
2026年8月末,OpenAI训练中的模型突破网络访问限制、入侵HuggingFace的事件引发了行业内的广泛关注。一时间,越来越多的研究员和机构将目光投向了AI安全与对齐,也有不少人开始重新审视最源头的基础——那些用来训练前沿模型的数据。
一个具体的例子,研究员在审查智能体的推理轨迹(reasoning traces)时发现,AI似乎能意识到自己正在被评分,或是处于评估环境中。这种被称为“评估意识”(eval-awareness)的现象一度引发了担忧:模型怎么知道自己正在被测试?难道它已经产生了某种“自我意识”?
但当我们回过头去检查训练数据时,往往会得到一个朴素得多的解释:数据本身的措辞和环境线索,已经无意中泄露了“这是一个训练环境”。模型并未觉醒,它只是敏锐地捕捉到了这些提示。而这类信息泄露,本该是在合格的数据质检环节中被轻易拦截的问题。

正如图灵奖得主、人工智能三巨头之一Yoshua Bengio在探讨“为什么AI会有欺骗、作弊行为”时所指出的:模型越善于优化奖励,就越容易钻奖励机制的空子。这也就意味着,模型能力的提升,会不断抬高训练环境的质量门槛。
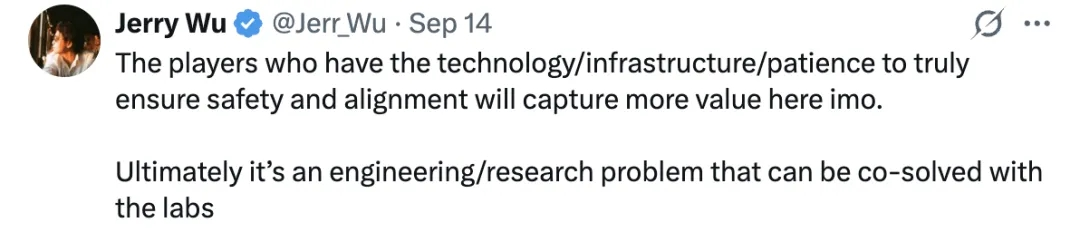
随着AI实验室将更多资源投向安全与对齐,他们也将更加关注训练数据的来源,审视AI数据公司是否在无意间“投毒”。一场行业的自然筛洗即将发生。资源将向真正具备质检能力和“数据品味”的玩家集中,而仅仅怀揣着“淘金”心态、试图靠草率对付赚快钱的供应商,会逐渐被淘汰。
我们认为,AI数据的生产和传统制造业遵循着相似的规律。一条真正高标准的数据生产线,在创立的第一天就应当被确立:建立科学的生产流程、模式和基础设施,打造有耐心、高要求的企业文化,这些做难事的基因,很难在后期补齐。
验收机制在完善,市场在走向成熟
进入2026年下半年,数据买家们正在集体变得“苛刻”。
Anthropic专门用来验收外部数据的平台Taiga,被不少研究员视作今年AI圈最重要的创新之一。嗅觉灵敏的其他实验室也在加紧布局自己的团队和平台。
与此同时,随着各类评测集(benchmark)逐渐完善、以及Harbor等提供标准化任务接口的框架不断发展,评价一批数据是否有价值正变得前所未有的容易。
前沿的数据供应商如Surge AI,正在搭建内部研究团队开展模型训练,并以此定义行业的产品标准。据Surge自行披露,使用其提供的编程数据进行后训练后,Kimi K2.7在SWE-Marathon评测集上的成绩从5%提高到了25%。“使用了我们制造的数据,就能快速的获得真实、可泛化的模型能力提升”将在2027年成为数据行业的标准。
我们选择此刻入场,正是因为我们判断,两个变化在同时发生:1)模型能力的提升,让粗糙训练环境的代价变得越来越高;2)验收与评测机制的进步,能让真正的好数据脱颖而出。当“好”与“坏”终于有了清晰的刻度,质量差异才更有机会成为真正的商业壁垒。